
네이버 플레이스 AI 개발 체험형 인턴 전형을 코딩테스트부터 기술 면접까지 거쳤다. 서류에서는 두 포지션에 함께 붙었는데, 규정상 하나만 골라야 해서 플레이스 AI 쪽을 택했다.
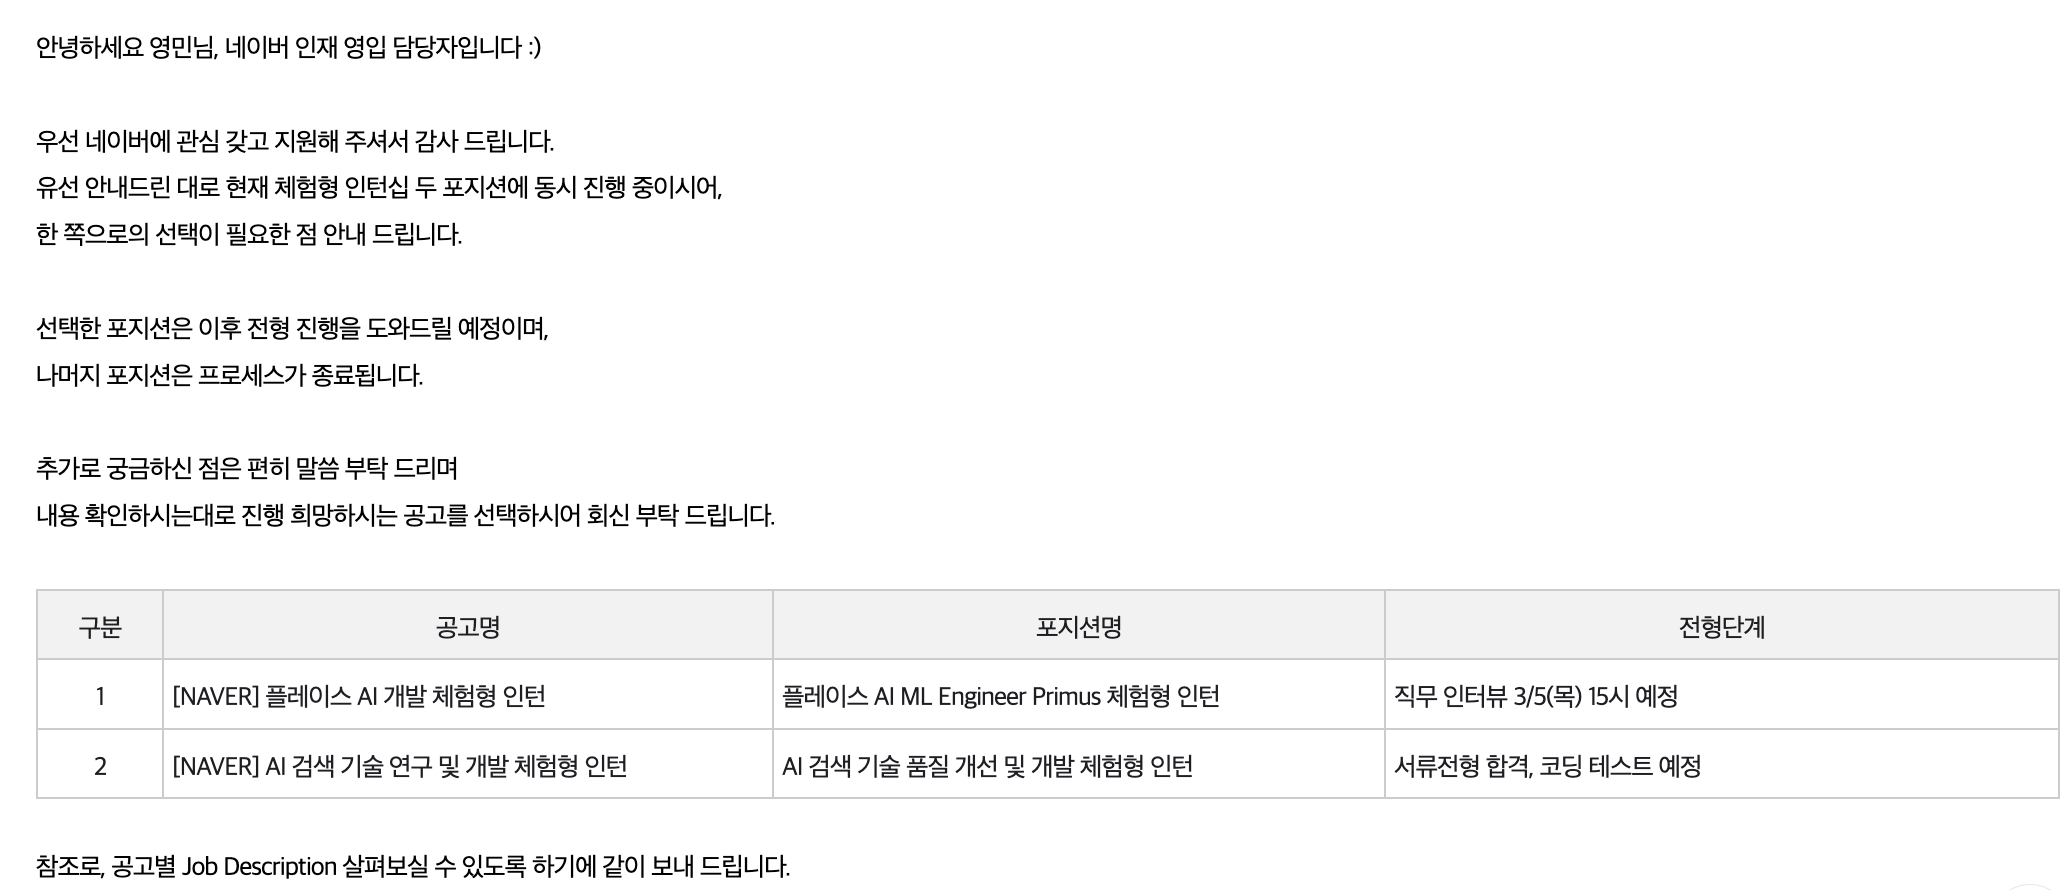
시험 문제는 응시 규정상 공개하지 않는다. 대신 무엇이 점수를 갈랐고, 면접에서 왜 막혔고, 다음에는 무엇을 먼저 할지를 적는다.
코딩테스트: 정답보다 먼저 막아야 할 입력
Codility에서 세 문제를 풀었다. 머신러닝 기법을 라이브러리 없이 직접 구현하는 문제, 데이터 전처리부터 모델 학습까지 짧은 파이프라인을 만드는 문제, 시간 복잡도를 줄여야 하는 알고리즘 문제였다.
세 문제 모두 평범한 입력에서는 금방 맞는다. 차이는 그다음이었다.
- 0으로 나누는 순간. 거리나 비율을 계산할 때 분모가 0이 되는 입력을 먼저 떠올려야 했다.
- 숨어 있는 결측치와 한쪽으로 쏠린 데이터. 겉보기에 깨끗한 표에도 빈 값이 섞여 있었고, 정답 비율이 한쪽으로 쏠려 있으면 정확도가 쉽게 부풀었다.
- 입력이 커질 때. 작은 예제에서 통과하는 코드가 큰 입력에서는 시간 안에 끝나지 않았다. 한 번 훑고 끝나는 방식으로 다시 짜야 했다.
정리하면, 알고리즘의 정석 경로만 아는 것으로는 부족했다. 이상한 입력을 먼저 떠올리는 쪽이 "제대로 구현했다"에 가까웠다.
기술 면접: 준비한 것과 나온 것이 달랐다
약 45분 동안 Zoom으로 봤다. 나는 머신러닝 기초 개념, 내 프로젝트 방어, LLM 관련 개념을 중심으로 준비했다.
실제 비중은 반대였다.
| 구분 | 준비한 정도 | 실제 비중 |
|---|---|---|
| 머신러닝·LLM 개념 | 많이 준비 | 짧게 몇 개 |
| 프로젝트 방어 | 준비함 | 한두 개 |
| 평가 시나리오 설계 | 거의 안 함 | 면접의 절반 이상 |
개념과 프로젝트 질문은 무난하게 넘어갔다. 이력서에 적은 수치를 어떻게 쟀는지 묻는 꼬리 질문도 근거가 있어서 버텼다.
막힌 곳은 평가 설계 질문이었다. 이 서비스에 맞는 LLM 평가를 한다면 어떤 사용자 유형을 만들고, 그 결과를 어떻게 분석하겠느냐는 흐름이었다. 공고에는 이 팀의 업무로 "도메인에 맞는 LLM 평가 체계 구축"이 분명히 적혀 있었다. 나는 그 줄을 읽기만 하고, 내가 직접 한다면 어떻게 할지까지는 생각해 보지 않았다. 정리되지 않은 말을 늘어놓는 수준에서 끝났다.
다음에는 이렇게 한다
- JD의 업무 항목마다 "내가 직접 설계한다면"을 미리 써 본다. 면접 질문은 결국 JD에서 나온다.
- 개념 정리보다 설계 연습에 시간을 더 쓴다. "X가 무엇인가"보다 "X를 어떻게 만들 것인가"가 면접의 중심이었다.
- 모르면 모른다고 하되, 생각하는 순서는 보여 준다. 억지로 답을 짜내려 할수록 더 어색해졌다.
돌아보면 두 관문은 같은 말을 했다. 코딩테스트는 정석 경로만으로 부족하다고, 면접은 개념만으로 부족하다고.